
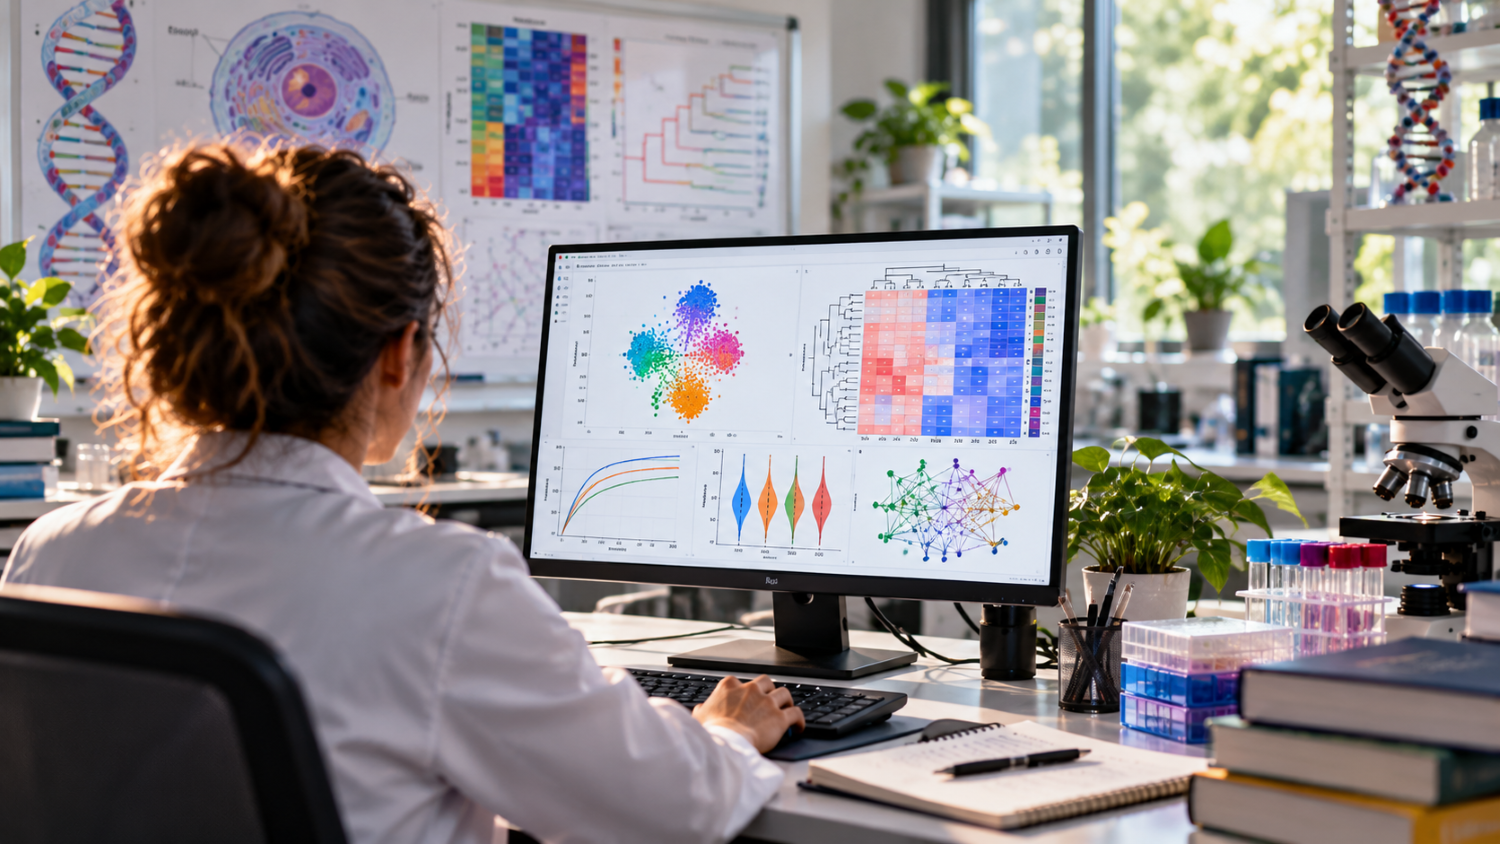
📚 Σκοπός του προγράμματος είναι να προσφέρει στους εκπαιδευόμενους/ες μια ολοκληρωμένη και πρακτικά προσανατολισμένη εισαγωγή στην Τεχνητή Νοημοσύνη και τη Μηχανική Μάθηση, χωρίς να απαιτεί προηγούμενη γνώση προγραμματισμού. Το πρόγραμμα αποσκοπεί στην εξοικείωσή τους με τη μετατροπή βιολογικών και βιοϊατρικών ερωτημάτων σε υπολογιστικές ροές εργασίας, καθώς και με την οργάνωση, προετοιμασία, ανάλυση και ερμηνεία πραγματικών βιολογικών δεδομένων μέσω οπτικών περιβαλλόντων εργασίας. Κύριο εκπαιδευτικό εργαλείο αποτελεί το Orange Data Mining, ενώ παρουσιάζονται βασικές δυνατότητες του KNIME και επιλεγμένων εργαλείων ανάλυσης εικόνων χωρίς κώδικα.
Ιδιαίτερη έμφαση δίνεται στην ορθή επιλογή και αξιολόγηση των μεθόδων Μηχανικής Μάθησης, στην αναγνώριση περιορισμών και πιθανών σφαλμάτων και στην επιστημονικά τεκμηριωμένη ερμηνεία των αποτελεσμάτων. Τελικός στόχος του προγράμματος είναι η ανάπτυξη της ικανότητας σχεδιασμού, εκτέλεσης, κριτικής αξιολόγησης και παρουσίασης ολοκληρωμένων και αναπαραγώγιμων ροών εργασίας Μηχανικής Μάθησης για εφαρμογές στις Βιοεπιστήμες.
Να αναλύεις δεδομένα χωρίς κώδικα: Να δημιουργείς ολοκληρωμένες ροές εργασίας Μηχανικής Μάθησης και Τεχνητής Νοημοσύνης μέσω οπτικών περιβαλλόντων (Orange Data Mining, KNIME).
Να προετοιμάζεις και να καθαρίζεις βιολογικά δεδομένα: Να εισάγεις, να διαχειρίζεσαι ελλιπείς ή ακραίες τιμές και να οπτικοποιείς σύνθετα δεδομένα (heatmaps, scatter plots).
Να μειώνεις τη διαστατικότητα και να εντοπίζεις μοτίβα: Να εξερευνάς πολύπλοκα σύνολα δεδομένων και να αναγνωρίζεις ομάδες με μεθόδους PCA, t-SNE και UMAP.
Να εκπαιδεύεις προγνωστικά μοντέλα: Να εφαρμόζεις αλγορίθμους ταξινόμησης και παλινδρόμησης (Random Forest, SVM, Decision Trees, k-NN, Logistic Regression) για προβλέψεις σε νέα δείγματα.
Να αξιολογείς και να βελτιστοποιείς μοντέλα: Να μετράς την απόδοση (ROC-AUC, F1-score, cross-validation) και να αποτρέπεις κινδύνους όπως overfitting, ανισορροπία κλάσεων και data leakage.
Να εφαρμόζεις ομαδοποίηση και επιλογή χαρακτηριστικών: Να ανακαλύπτεις βιολογικές υποομάδες (clustering) και να ιεραρχείς τις πιο καθοριστικές μεταβλητές (feature selection).
Να ερμηνεύεις προβλέψεις με Επεξηγήσιμη ΤΝ: Να εξηγείς τις αποφάσεις των μοντέλων μέσω τεχνικών όπως SHAP και LIME, συνδέοντάς τες με πραγματικούς βιολογικούς μηχανισμούς.
Να αναλύεις βιολογικές εικόνες και να διασφαλίζεις αναπαραγωγιμότητα: Να υλοποιείς no-code ταξινόμηση εικόνων και να τεκμηριώνεις πλήρη, επιστημονικά έγκυρα workflows.
-
1) Από το βιολογικό ερώτημα στο workflow Μηχανικής Μάθησης
Παρουσιάζονται οι βασικές έννοιες της Μηχανικής Μάθησης και ο τρόπος με τον οποίο ένα βιολογικό ερώτημα μετατρέπεται σε πρόβλημα ανάλυσης δεδομένων. Οι εκπαιδευόμενοι/ες γνωρίζουν το περιβάλλον Orange και δημιουργούν το πρώτο τους οπτικό workflow.
-
Τεχνητή Νοημοσύνη, Μηχανική Μάθηση και Βαθιά Μάθηση
-
Ταξινόμηση, παλινδρόμηση και ομαδοποίηση
-
Παραδείγματα εφαρμογών στις Βιοεπιστήμες
-
Δείγματα, χαρακτηριστικά, ετικέτες και στόχοι
-
No-code και low-code περιβάλλοντα
-
Εισαγωγή στο Orange και πρώτο workflow
-
-
2) Βιολογικά δεδομένα και προετοιμασία συνόλων δεδομένων
Οι συμμετέχοντες/ουσες μαθαίνουν να οργανώνουν και να προετοιμάζουν βιολογικά δεδομένα για ανάλυση, αναγνωρίζοντας τύπους μεταβλητών, ελλιπείς τιμές και προβλήματα ποιότητας που μπορούν να επηρεάσουν τα αποτελέσματα.
-
Τύποι βιολογικών και βιοϊατρικών δεδομένων
-
Δομή πινάκων δεδομένων και μεταδεδομένων
-
Αριθμητικές, κατηγορικές και διατεταγμένες μεταβλητές
-
Ελλιπείς τιμές, διπλότυπα και ακραίες τιμές
-
Κανονικοποίηση και κλιμάκωση
-
Βασικές αρχές ποιότητας δεδομένων
-
-
3) Εισαγωγή, καθαρισμός και οπτικοποίηση δεδομένων στο Orange
Παρουσιάζονται οι βασικές τεχνικές εισαγωγής, καθαρισμού και μετασχηματισμού δεδομένων στο Orange, καθώς και εργαλεία οπτικοποίησης για τη διερεύνηση προτύπων και σχέσεων στα δεδομένα
-
Εισαγωγή αρχείων CSV, TSV και Excel
-
Επιλογή και μετασχηματισμός μεταβλητών
-
Πίνακες, κατανομές και box plots
-
Scatter plots και συσχετίσεις
-
Heatmaps και οπτική εξερεύνηση
-
Αποθήκευση, τεκμηρίωση και αναπαραγωγιμότητα workflows
-
-
4) Μείωση διαστάσεων και εξερευνητική ανάλυση
Εισάγονται οι τεχνικές PCA, t-SNE και UMAP για τη μείωση διαστάσεων και την εξερεύνηση πολύπλοκων βιολογικών δεδομένων. Δίνεται έμφαση στην αναγνώριση ομάδων, ακραίων τιμών και πιθανών τεχνικών επιδράσεων.
-
Η ανάγκη μείωσης διαστάσεων
-
Principal Component Analysis (PCA)
-
t-SNE και UMAP
-
Ερμηνεία προβολών και ομάδων
-
Εντοπισμός ακραίων δειγμάτων
-
Περιορισμοί και συχνές παρερμηνείες
-
-
5) Μοντέλα επιβλεπόμενης μάθησης για βιολογικές προβλέψεις
Παρουσιάζονται οι βασικοί αλγόριθμοι ταξινόμησης και παλινδρόμησης και η εφαρμογή τους σε προβλήματα των βιοεπιστημών. Οι εκπαιδευόμενοι/ες δημιουργούν και εφαρμόζουν προγνωστικά μοντέλα χωρίς συγγραφή κώδικα.
-
Train, validation και test sets
-
Logistic Regression και Naive Bayes
-
k-Nearest Neighbors
-
Decision Trees και Random Forest
-
Support Vector Machines
-
Παλινδρόμηση και πρόβλεψη συνεχών τιμών
-
Πρόβλεψη νέων βιολογικών δειγμάτων
-
-
6) Αξιολόγηση, σύγκριση και βελτιστοποίηση μοντέλων
Παρουσιάζονται οι σημαντικότερες μέθοδοι αξιολόγησης και σύγκρισης μοντέλων Μηχανικής Μάθησης, καθώς και τεχνικές βελτίωσης της απόδοσής τους. Παράλληλα αναλύονται συχνά προβλήματα, όπως το overfitting, η ανισορροπία κλάσεων και το data leakage.
-
Confusion matrix
-
Accuracy, precision, recall και F1-score
-
ROC curves και AUC
-
Cross-validation
-
Σύγκριση αλγορίθμων
-
Overfitting και γενίκευση
-
Ανισορροπία κλάσεων και data leakage
-
-
7) Ομαδοποίηση, επιλογή χαρακτηριστικών και ανακάλυψη προτύπων
Οι συμμετέχοντες/ουσες θα γνωρίσουν τεχνικές μη επιβλεπόμενης μάθησης και επιλογής χαρακτηριστικών για την ανακάλυψη βιολογικών υποομάδων και σημαντικών μεταβλητών σε πολύπλοκα σύνολα δεδομένων
-
Ιεραρχική ομαδοποίηση και k-means
-
Αποστάσεις και μέτρα ομοιότητας
-
Heatmaps και δενδρογράμματα
-
Feature ranking και feature selection
-
Αναγνώριση βιολογικών υποομάδων
-
Αξιολόγηση και ερμηνεία clusters
-
-
8) Επεξηγήσιμη Τεχνητή Νοημοσύνη και βιολογική ερμηνεία
Παρουσιάζονται βασικές τεχνικές ερμηνείας των προβλέψεων των μοντέλων και αξιολόγησης της σημασίας των χαρακτηριστικών. Δίνεται έμφαση στη σύνδεση των υπολογιστικών αποτελεσμάτων με ουσιαστικά βιολογικά συμπεράσματα.
-
Γιατί χρειάζεται επεξηγήσιμη Τεχνητή Νοημοσύνη
-
Σημαντικότητα χαρακτηριστικών
-
Ερμηνεία μεμονωμένων προβλέψεων
-
Βασικές έννοιες SHAP και LIME
-
Σύνδεση μοντέλου με βιολογικούς μηχανισμούς
-
Επικοινωνία αβεβαιότητας και περιορισμών
-
Ηθική, μεροληψία και υπεύθυνη χρήση
-
-
9) KNIME, εφαρμογές εικόνας και ολοκληρωμένο αναπαραγώγιμο workflow
Οι εκπαιδευόμενοι/ες εισάγονται στο περιβάλλον KNIME και σε εφαρμογές no-code ανάλυσης εικόνας, ολοκληρώνοντας ένα πλήρες και αναπαραγώγιμο workflow Μηχανικής Μάθησης από τα δεδομένα έως την τελική ερμηνεία των αποτελεσμάτων.
-
Εισαγωγή στο KNIME και βασικοί κόμβοι
-
Orange και KNIME: δυνατότητες και διαφορές
-
No-code ταξινόμηση βιολογικών εικόνων
-
Πότε απαιτείται προγραμματισμός
-
Ολοκληρωμένο workflow από τα δεδομένα στο συμπέρασμα
-

- Συνολικός χρόνος ενασχόλησης: 75 ώρες
- Online μαθήματα με τους εκπαιδευτές: 18 ώρες
- Διάρκεια: 9 Εβδομάδες
- Επωφεληθείτε από τις εκπτώσεις στα δίδακτρα έως 35%
- 🎓 Απονέμεται Πιστοποιητικό Επιμόρφωσης